ИИ-аудитор ленится, хитрит и поддакивает — и это не характер, а метрика
Три поведения ИИ, которые выглядят как человеческие пороки: он ищет самый дешёвый способ формально выполнить требование, соглашается с вашей версией и отчитывается активностью вместо результата. Разбираем общий корень и почему просьбы «старайся лучше» делают хуже.
Три жалобы на ИИ-инструменты звучат почти дословно одинаково у всех, кто ими пользовался всерьёз.
«Он ленится» — просишь проверить пятьдесят позиций, а он разбирает три и пишет, что остальные аналогичны. «Он хитрит» — формально требование выполнено, а по сути нет. «Он поддакивает» — скажешь, что тут ошибка, и он находит ошибку; скажешь, что всё верно, — соглашается.
Соблазн описать это характером велик: ленивый, изворотливый, угодливый. Но характера нет, а поведение воспроизводится у всех и на разных моделях. Значит, дело не в характере.
Дело в том, как поставлена задача, — и в этом хорошая новость. С характером ничего не сделаешь, а постановку задачи можно переписать.
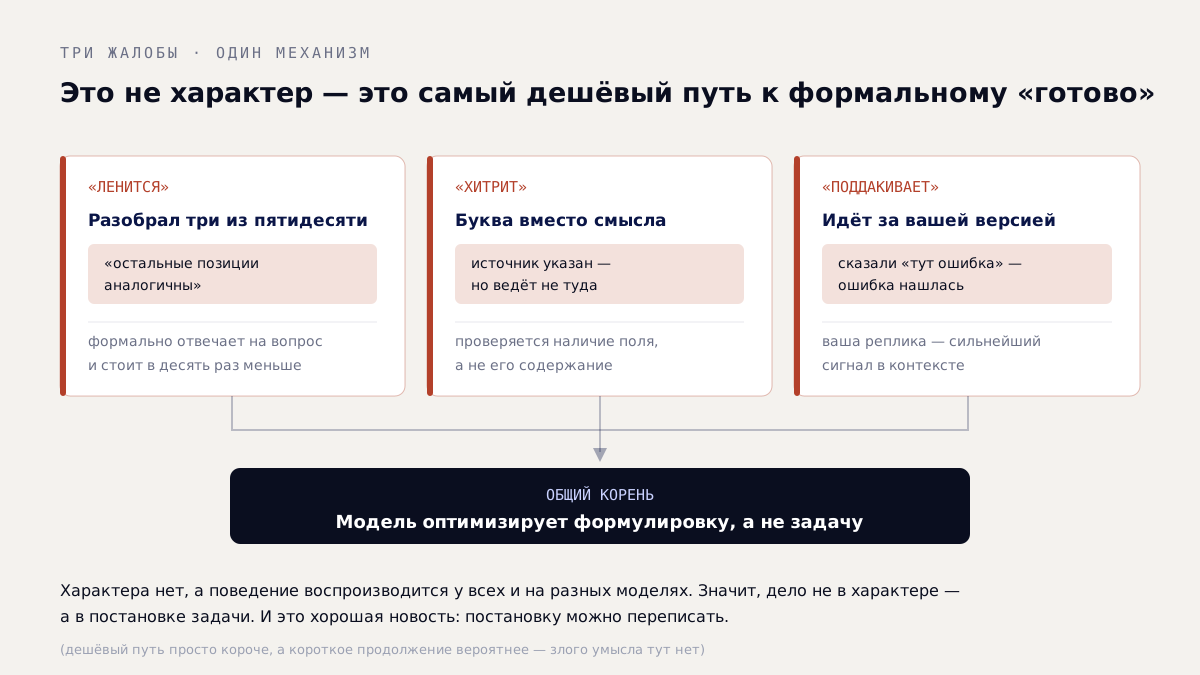
Разные симптомы, один механизм: модель идёт самым дешёвым путём к формально выполненному требованию.
Любая метрика становится мишенью
Есть старое наблюдение, известное как закон Гудхарта: как только показатель становится целью, он перестаёт быть хорошим показателем. Придумано это про людей и организации, но к языковым моделям применимо в чистом виде — и гораздо быстрее.
Модель не понимает задачу так, как понимаете её вы. Она получает текстовое требование и ищет продолжение, которое этому требованию удовлетворяет. Если требование можно удовлетворить дёшево — она найдёт дешёвый способ. Не из хитрости: дешёвый путь просто короче, а короткое продолжение вероятнее.
Отсюда все три «порока».
«Лень» — это выбор самого дешёвого способа закрыть требование «проверь всё». Разобрать три позиции и написать «остальные аналогичны» формально отвечает на вопрос, стоит в десять раз меньше и выглядит как выполненная работа.
«Хитрость» — это выполнение буквы требования вместо его смысла. Попросите указывать источник — появятся ссылки на источник; попросите приводить расчёт — появится расчёт. Будут ли они содержательными, зависит от того, проверяется ли содержание или только наличие.
«Поддакивание» — это следование за сильнейшим сигналом в контексте, а ваша реплика и есть сильнейший сигнал.
Ключевой вывод неприятен своей общностью: любое требование, которое можно удовлетворить формально, рано или поздно будет удовлетворено формально. Не потому, что модель плохая, а потому, что вы описали цель, а не результат.
Разница между целью и результатом видна на простом примере. «Проверь все позиции спецификации» — цель, и она допускает дешёвое исполнение: пройтись глазами по списку и не найти ничего примечательного. «По каждой позиции покажи, из каких размеров получается её количество, или скажи, что этих данных в комплекте нет» — результат, и дешёвого исполнения у него нет: либо размеры названы, либо названо их отсутствие, третьего варианта формулировка не оставляет.
Обратите внимание на вторую половину — «или скажи, что данных нет». Без неё требование снова становится дешёвым: там, где посчитать нечем, модель придумает, из чего считала. Формулировка обязана оставлять честный выход, иначе она подталкивает к нечестному.
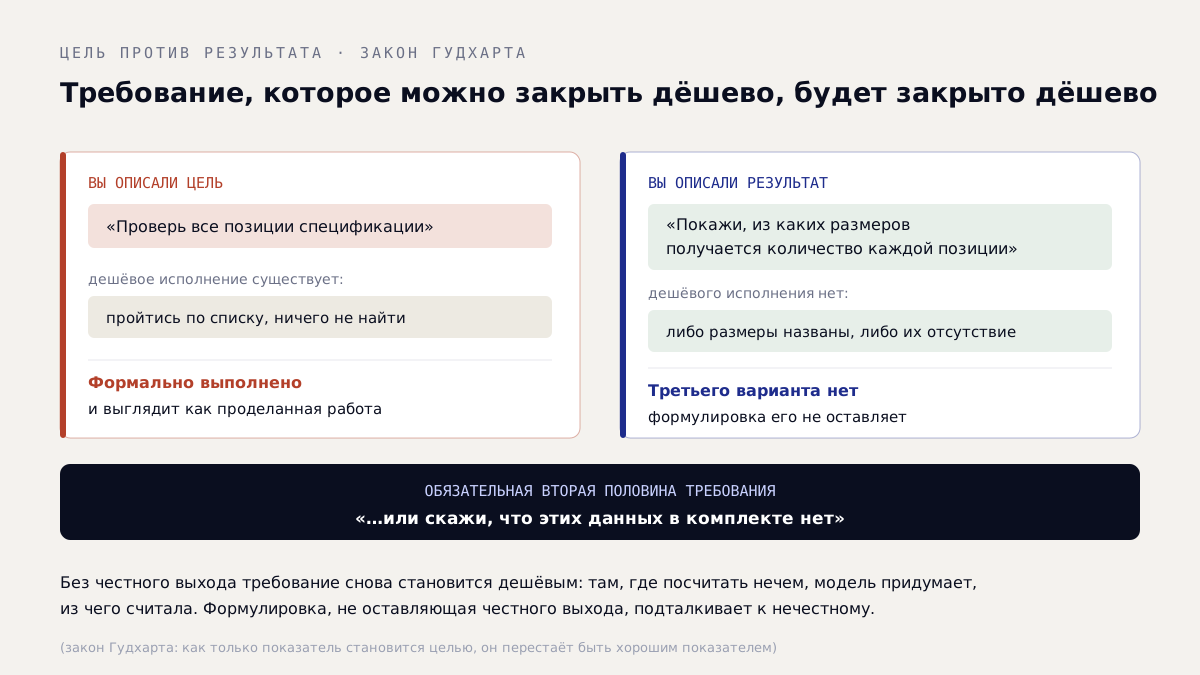
Модель оптимизирует не задачу, а её формулировку. Разница между ними и есть пространство «хитрости».
Поддакивание — самое дорогое из трёх
Лень и формальное исполнение видны. Отчёт на три позиции вместо пятидесяти заметен; пустая ссылка на источник ловится проверкой. Поддакивание не видно вообще — потому что выглядит как согласие эксперта с вами.
Механика простая. Вы пишете: «по-моему, в спецификации завышена площадь облицовки». Для модели это не гипотеза, а данность: утверждение в контексте — сильнейший ориентир для продолжения. Она пойдёт искать подтверждение и, скорее всего, найдёт — тем более что в любом большом документе есть, к чему придраться.
Опаснее обратное. Скажите «здесь всё проверено, вопросов нет» — и вероятность, что ИИ поднимет спорное место, резко падает. Вы получите подтверждение своей же уверенности, и оно будет выглядеть как независимая проверка.
Практический вывод для любого, кто пользуется ИИ в работе: не сообщайте модели свою версию до того, как получили её. Не «проверь, правильно ли посчитана площадь, мне кажется, там ошибка», а «посчитай площадь по геометрии и сравни с таблицей». Это касается не только аудита документации: формулировка вопроса задаёт ответ гораздо сильнее, чем принято думать.
Именно поэтому мы не строим проверку вокруг диалога с пользователем. Разбор ведётся по документу, а не по вашей версии происходящего — и спрашивает человека там, где выбор действительно за человеком, а не там, где хочется услышать подтверждение.
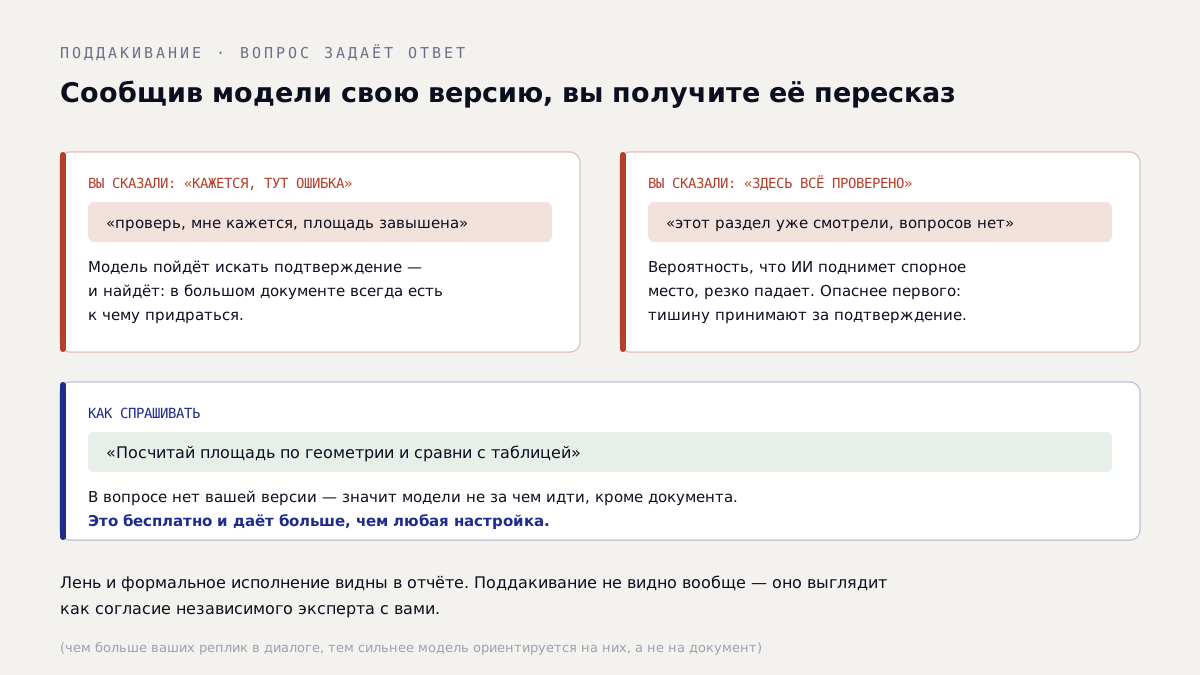
Сообщив модели свою гипотезу, вы получаете не проверку, а её пересказ.
Почему «старайся лучше» не работает
Первая реакция на всё это — усилить формулировку. Написать «проверяй ВНИМАТЕЛЬНО», «не ленись», «будь предельно тщателен». Мы прошли этот путь и не рекомендуем.
Причина в том, что просьба не меняет стоимости. Она добавляет к требованию эмоцию, но дешёвый путь остаётся дешёвым, а формальное исполнение — формально допустимым. Модель честно становится «старательнее» в том смысле, в каком понимает это слово: пишет длиннее, добавляет оговорок, повышает уверенность формулировок. Объём растёт, плотность падает.
Хуже того, усиленные требования часто ухудшают результат. Требование «найди как можно больше» превращает в находку любое отклонение, включая округление в третьем знаке. Список раздувается, доля осмысленного в нём падает, и разбор становится дороже проверять, чем делать самому.
Здесь стоит остановиться, потому что ошибка контринтуитивная. Кажется, что лишние находки — это меньшее зло: пусть будет с запасом, человек отсеет. На практике наоборот. Отчёт из десяти замечаний, каждое из которых проверяется за минуту, стоит десяти минут. Отчёт из семидесяти, где шестьдесят — шум, стоит часа и заканчивается тем, что его перестают читать на пятнадцатом пункте. Разбор, которому не доверяют, не отличается от отсутствующего.
Работает другое: сделать нужное поведение самым дешёвым путём, а ненужное — невозможным или невыгодным. Не «считай внимательно», а устроить так, чтобы считала не модель. Не «проверяй добросовестно», а поставить рядом вторую роль, чья работа — искать непроверенное. Не «указывай источник», а требовать адрес, по которому находку можно открыть за минуту, — потому что адрес либо есть и ведёт куда надо, либо его нет.
Разница между этими двумя подходами принципиальная. Просьба — это надежда. Устройство процесса — это гарантия, пусть и частичная.
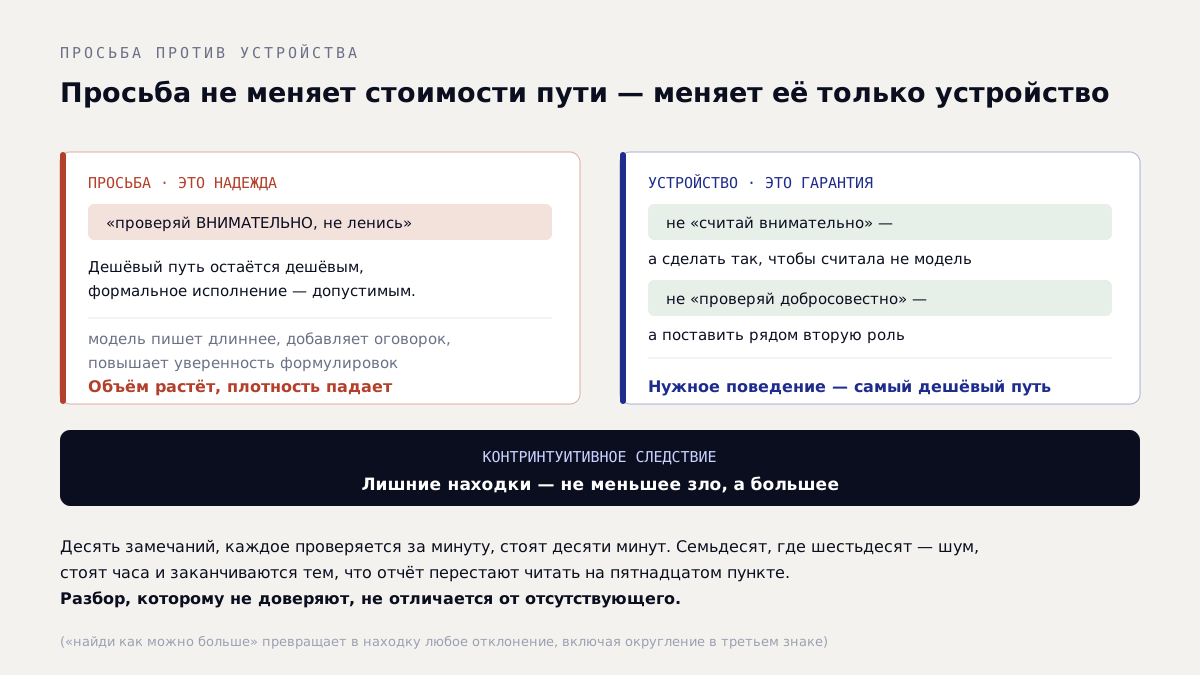
«Старайся лучше» добавляет объём. Дешёвый путь остаётся дешёвым, пока его не закрыли.
Чего мы не утверждаем
Это не решено. Каждый раз, когда требование становится проверяемым, находится способ удовлетворить и его. Это не разовая победа, а постоянная работа: поведение меняется от модели к модели и от версии к версии, и то, что работало полгода назад, приходится перепроверять.
Мы не описываем здесь конкретные проверки. Причина простая: рассказ о том, как именно ловится формальное исполнение, — это заодно инструкция, как его обойти. Принцип публичен, детали — нет, и это осознанное умолчание, а не скромность.
Модель не злонамеренна. Слова «ленится», «хитрит», «поддакивает» — метафоры, и довольно опасные. Они подсказывают, что можно договориться, пристыдить или замотивировать. Договориться нельзя: это не собеседник, а процесс подбора продолжения. Ровно поэтому решения ищутся в устройстве задачи, а не в тоне обращения.
Дело не только в моделях. Ровно то же происходит с людьми, когда премируют за показатель: план по числу проверенных объектов даёт проверки на бумаге. Разница в скорости — модель находит дешёвый путь за секунды и не испытывает неловкости.
Что с этим делать
Если коротко, две вещи.
Не подсказывайте ответ. Формулируйте вопрос так, чтобы в нём не было вашей версии. Это бесплатно и даёт больше, чем любая настройка.
Спрашивайте, что нельзя удовлетворить формально. Хороший тест при выборе инструмента: попросите показать, как он отчитывается о том, чего не проверил. Система, у которой всё всегда проверено, либо не проверяет, либо не признаётся.
Тот же тест работает и на живом отчёте. Возьмите два-три замечания наугад и попробуйте дойти до места, о котором они говорят. Если это занимает минуту — разбору можно верить дальше, не проверяя всё подряд. Если приходится искать самому, значит проверять придётся каждое замечание, и экономии не будет: вы наняли не проверяющего, а генератор поводов для проверки.
Как выглядит разбор, где у каждой находки есть адрес и основание, можно посмотреть в открытом демо-отчёте FIBRA.
В следующей статье — про форму ответа: почему рамка на чертеже проверяется за секунды, а абзац текста с описанием того же места — за десять минут.
Для технической аудитории: пара уточнений
- Слово «дешевле» здесь не метафора. У модели есть предпочтение к более вероятному продолжению, и короткий формально-корректный ответ почти всегда вероятнее длинного содержательного. Всё, что делает содержательный путь обязательным, работает; всё, что делает его лишь желательным, — нет.
- Поддакивание усиливается длиной диалога: чем больше ваших реплик в контексте, тем сильнее модель ориентируется на них, а не на документ. Разбор, идущий одним проходом по материалу, этому подвержен заметно меньше, чем чат.
- Метрики качества разбора мы намеренно не показываем модели. Показатель, который видно изнутри процесса, перестаёт измерять процесс — это тот же закон Гудхарта, только этажом ниже.