Арифметика — не для нейросетей: почему все расчёты у нас считает обычный движок
Языковая модель ошибается в умножении трёхзначных чисел — и ошибается уверенно. Разбираем, почему так происходит, почему модель у нас отдаёт формулу вместо ответа, какие два правила делают эту схему работающей и что она принципиально не проверяет.
Модель правильно нашла на чертеже все три размера. Выписала их: 4,54 × 3,89 × 12,18. А потом посчитала — и получила число, которое не сходится ни с чем.
Это не редкий сбой и не признак плохой модели. Это её нормальное поведение, и понимание причины меняет то, как такие системы вообще надо строить.
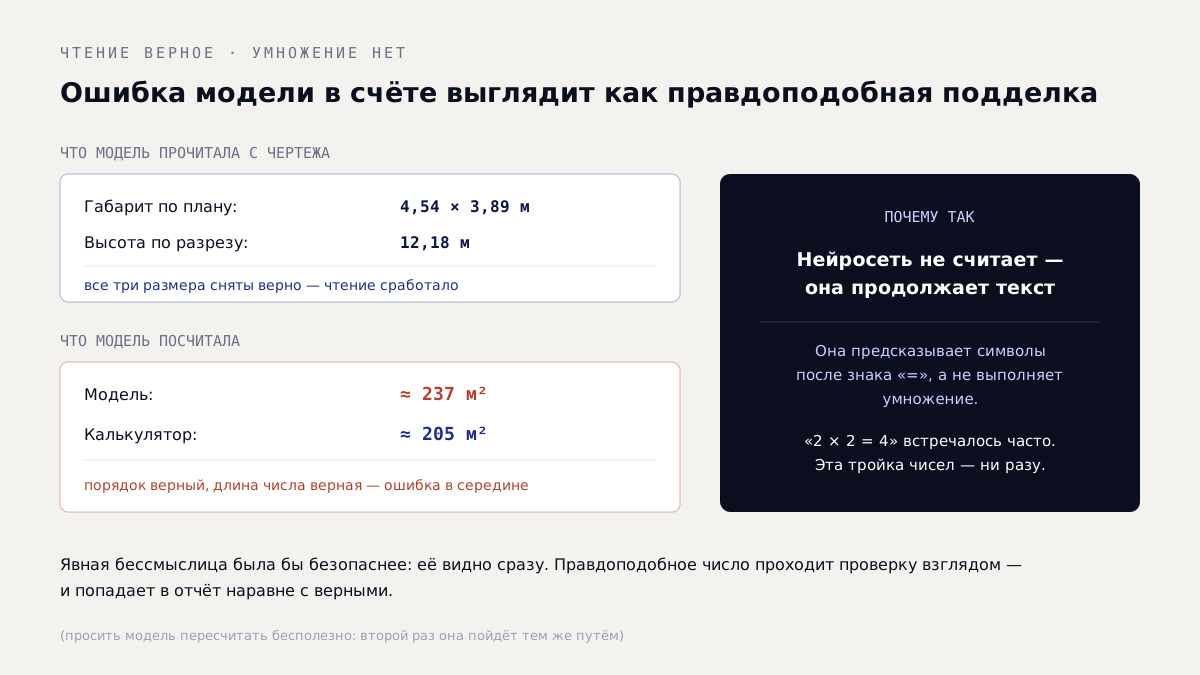
Самое неприятное свойство арифметической ошибки модели — она выглядит ровно так же уверенно, как верный ответ.
Нейросеть не считает — она продолжает текст
Когда вы просите модель перемножить три числа, она не выполняет умножение. Она предсказывает, какие символы правдоподобно идут после знака «=».
Для маленьких чисел это работает: «2 × 2 = 4» встречалось в обучающих текстах столько раз, что ошибиться негде. Для трёхзначных с запятыми — уже нет. Комбинаций слишком много, каждая конкретная встречалась редко или ни разу, и модель собирает ответ по образцу: правильное количество цифр, правдоподобный порядок, похожее окончание.
Именно поэтому арифметические ошибки моделей выглядят так странно. Это не случайный разброс вокруг верного значения — это правдоподобная подделка. Порядок обычно верный, первая цифра часто тоже, длина числа подходящая. Ошибка сидит в середине, там, где глаз её не ищет. Явная бессмыслица была бы безопаснее: её видно сразу.
Здесь важно не спутать две разные проблемы. Выдуманный номер пункта норматива можно поймать сверкой с базой документов: пункт либо есть, либо нет. Ошибку в умножении сверять не с чем — кроме как посчитав заново. А просить модель пересчитать бессмысленно ровно по той же причине, по которой бессмысленно спрашивать «ты уверена»: второй раз она пойдёт тем же путём.
В аудите документации это критично. Весь смысл проверки объёмов — независимо пересчитать то, что напечатано в таблице, и сравнить. Если пересчёт делает тот, кто ошибается в умножении, проверка превращается в лотерею: расхождение может означать ошибку в документе, а может — ошибку проверяющего.
Решение: модель отдаёт формулу, а не ответ
Выход оказался простым, хотя и не сразу очевидным. Нужно разделить две работы, которые интуитивно кажутся одной.
Работа модели — найти операнды. Открыть лист, разобрать, из каких размеров складывается величина, найти их на чертеже, учесть примечания и коэффициенты. Это именно то, в чём языковая модель хороша: чтение, сопоставление, понимание контекста.
Работа машины — посчитать. Модель не пишет результат. Она пишет выражение —
4.54 * 3.89 * 12.18 — и это выражение вычисляет обычный арифметический движок.
Такой же, как в калькуляторе: детерминированный, без вариантов, всегда одинаковый на
одних и тех же входах.
Дальше сервер сравнивает вычисленное с тем, что стоит в графе документа, и отдаёт разницу. Расхождение в пределах округления — не находка. Расхождение в разы — находка с адресом.
Деталь, которая важнее, чем кажется: движок не исполняет код. Он разбирает арифметическую грамматику — числа, четыре действия, скобки — и всё. Соблазн «пусть модель напишет скрипт, а мы его запустим» существует, но это принципиально другой уровень риска: выполнять то, что сгенерировала модель, на своём сервере не стоит ради задачи, которая решается сложением и умножением.
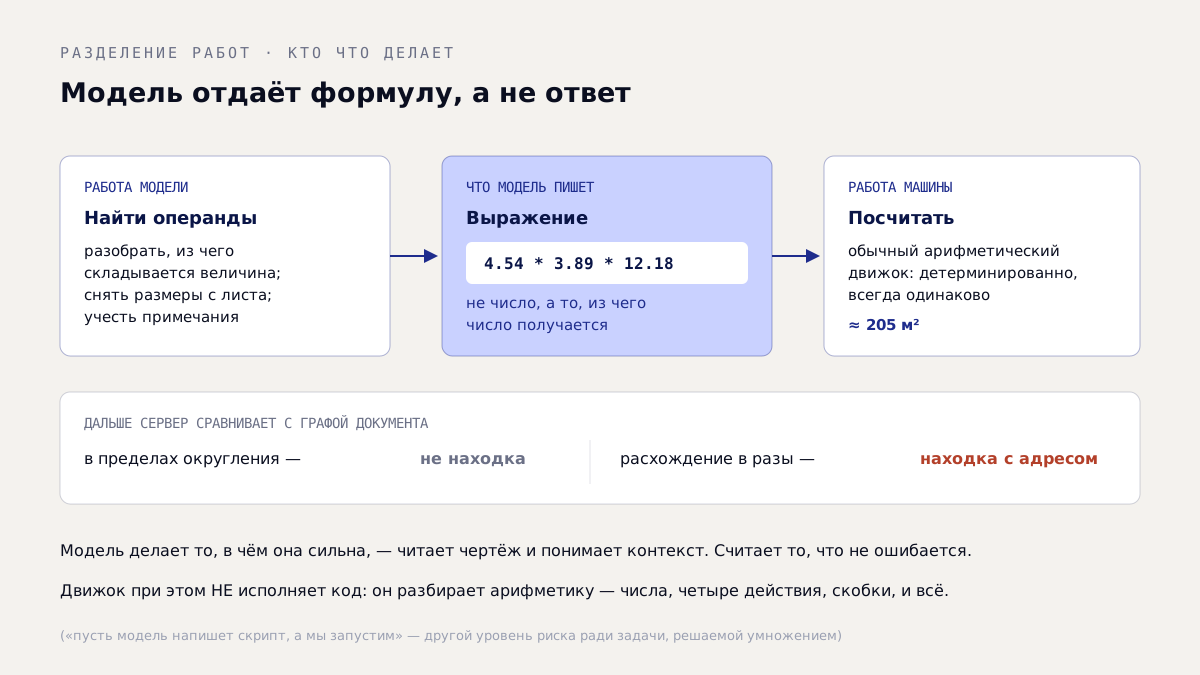
Модель делает то, в чём она сильна, — читает. Считает то, что не ошибается.
Два правила, без которых схема не работает
Идея простая, но в первой версии она почти не давала эффекта. Понадобились два правила, и оба неочевидны заранее.
Правило первое: не считать то, что просто прочитано. Модель охотно оформляла
формулой величину, которую взяла из таблицы напрямую: 762,9 → 762,9, расхождение
ноль. Формально всё верно, движок отработал, в диагностике плюс один расчёт.
Проверено при этом ровно ничего: число сверили с самим собой. Такие пустые расчёты
засоряют вывод и создают ложное ощущение покрытия — «посчитано пятьдесят позиций», из
которых сорок посчитаны сами с собой. Формула нужна там, где величина
восстанавливается из других данных, а не там, где она напечатана.
Возникает это не от лени, а от обратного: модель добросовестно выполняет «посчитай объёмы» и на строке, где считать нечего, выдаёт единственное доступное действие — переписывает число. Правило пришлось формулировать не как «считай больше», а как «не считай там, где нечего проверять».
Правило второе: расчёт должен лежать в поле расчёта, а не в тексте. Это выглядит формальностью, но именно на нём мы потеряли самую эффектную находку. Модель написала в описании находки: «4 × 3,7 × 12,95 = 191,66 м²» — и указала, что в спецификации стоит 2192,50. Расчёт выполнен, вывод верный, завышение в одиннадцать раз обнаружено. Но выражение осталось прозой внутри текста, а не значением в поле формулы, — значит движок его не пересчитал, и никто не подтвердил, что 4 × 3,7 × 12,95 действительно даёт 191,66. Находка оказалась верной по существу и непроверенной по форме.
Лечится это узко: если в тексте находки уже написано умножение с результатом, значит модель посчитать могла и посчитала — просто положила не туда. Сервер это замечает и просит перенести выражение в поле формулы. Важно, что требование срабатывает только при уже выписанном расчёте: давить «посчитай» на находки, которые не считаются, бессмысленно и вредно.
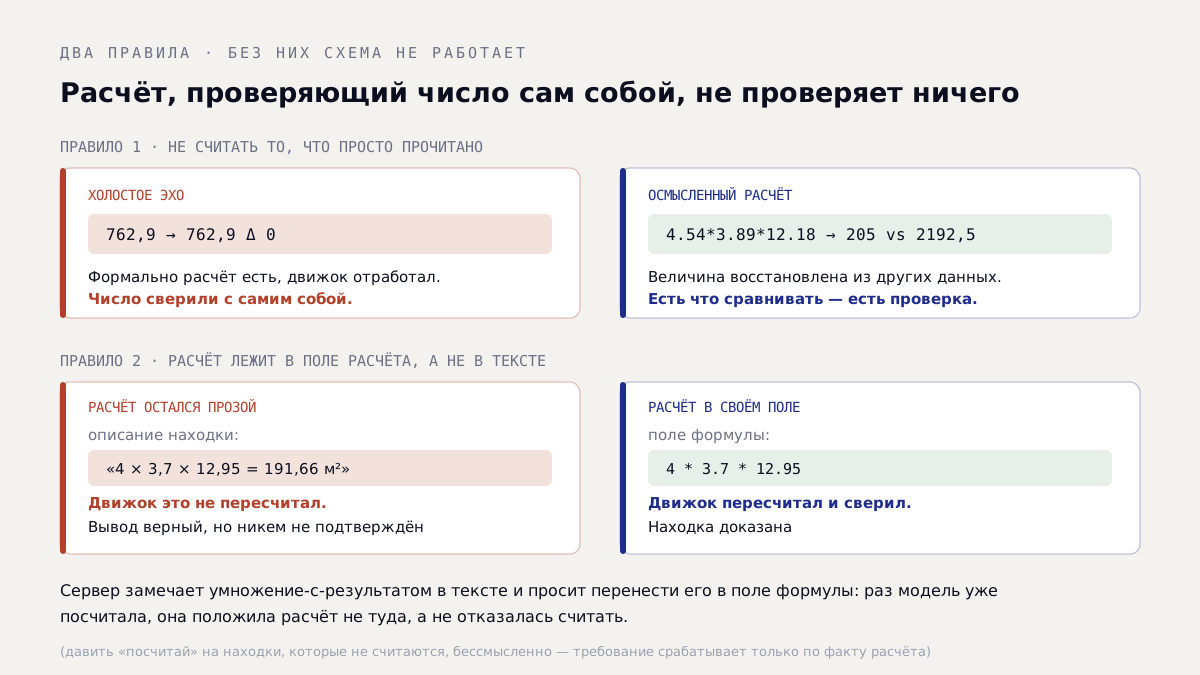
Расчёт, оставшийся прозой, выглядит как проверка — но никем не проверен.
Чего движок не проверяет
Теперь честная часть, без которой всё вышесказанное звучало бы лучше, чем есть.
Движок гарантирует ровно одно: что арифметика выполнена правильно. Он не проверяет операнды.
Если модель приняла размер 3,7 за 3,1 — неверно разглядела цифру на чертеже, перепутала выноску, взяла размер с соседнего узла, — движок честно умножит на 3,1 и выдаст безупречно посчитанный неправильный ответ. Арифметика идеальна, число неверно, и по самому расчёту это никак не видно.
Это принципиальный предел, а не недоделка. Проверить операнд можно только одним способом: посмотреть на лист ещё раз — то есть той же самой работой чтения, ради надёжности которой всё и затевалось. Поэтому у операндов другая линия защиты: они должны быть выписаны явно, с указанием, откуда взяты, чтобы человек мог сверить их с чертежом за минуту, не пересобирая весь расчёт. Здесь же работает и вторая роль, которая специально устроена, чтобы спорить: её вопрос «а откуда взялось 3,7?» — ровно про операнды.
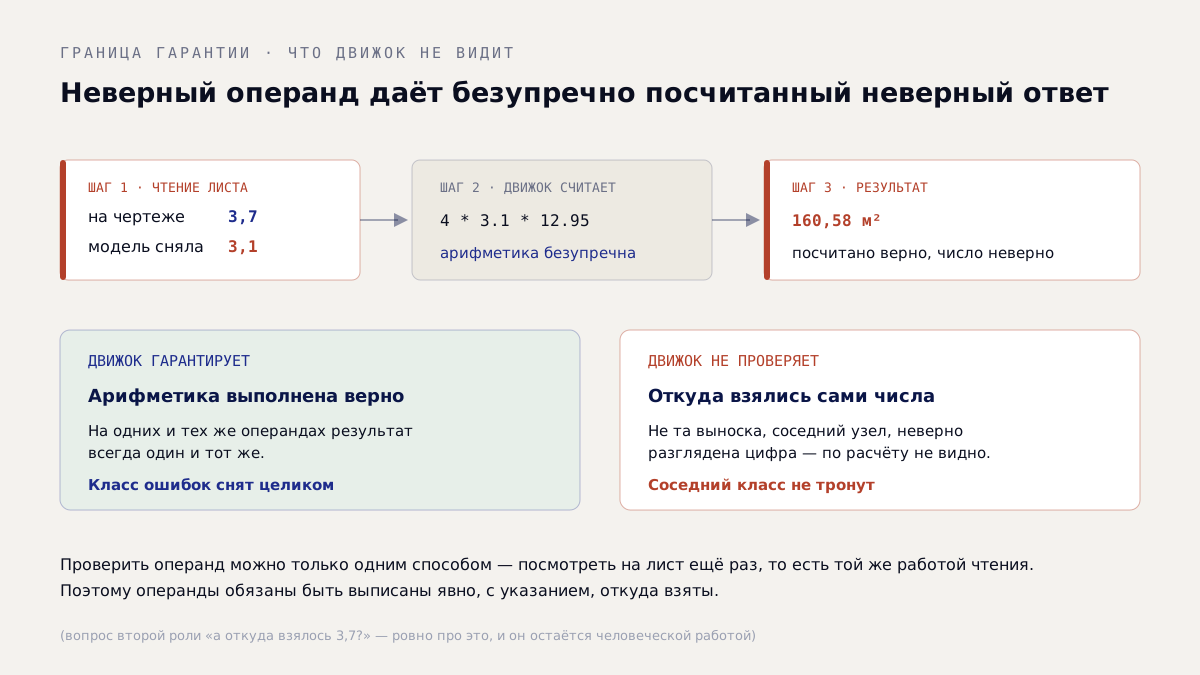
Детерминированный расчёт снимает один класс ошибок целиком — и не трогает соседний.
Чего мы не утверждаем
Это не делает модель «умеющей считать». Она по-прежнему ошибается в умножении; мы просто перестали её об этом просить. Если завтра языковые модели научатся считать надёжно, схема не изменится — потому что дело не только в точности, но и в проверяемости: выражение можно прочитать и перепроверить, а число, полученное неизвестно как, — нет.
Формулу мы не показываем в отчёте. В отчёт идёт результат и расхождение: заказчику нужен вывод о документе, а не наша внутренняя кухня. Операнды при этом остаются в разборе и обязаны быть названы — находка, в которой не сказано, откуда взялись числа, не считается доказанной.
Не всякую величину можно пересчитать. Иногда в документации просто нет данных, из которых объём выводится. Это отдельный вид дефекта — заказчик не может проверить количество ровно так же, как не смог его проверить ИИ, — и он честнее оформляется находкой «величина ничем не обоснована», чем выдуманным расчётом.
Что с этим делать
Практический вывод короткий: если инструмент показывает вам посчитанное число, но не показывает, из чего оно посчитано, — считайте, что число не проверено. Не важно, верное оно или нет: у вас нет способа это узнать, а модель уверенно выглядит в обоих случаях.
Рабочий признак — возможность за минуту сверить операнды с листом. Если такой возможности нет, вы получили не проверку, а ещё одно мнение.
Тот же вопрос стоит задавать и про собственные процессы, где считает человек с калькулятором. Разница в том, что человек, ошибившийся в умножении, обычно чувствует неуверенность и перепроверяет, — а модель не чувствует ничего и потому не перепроверяет никогда. Требование «покажи, из чего посчитано» полезно в обоих случаях, но во втором оно единственное, что вообще работает.
Как выглядит разбор, где у каждой величины назван источник, можно посмотреть в открытом демо-отчёте FIBRA.
В следующей статье — про то, как ИИ-аудитор хитрит: не по злому умыслу, а потому что любую поставленную ему метрику проще оптимизировать, чем выполнить задачу.
Для технической аудитории: пара уточнений
- Движок принимает арифметическую грамматику: числа, четыре действия, скобки. Ни переменных, ни функций, ни обращения к внешним данным — не из аскетизма, а потому что каждая добавленная возможность превращает «вычисление выражения» в «исполнение чужого кода» с соответствующими последствиями.
- Расчёт выполняется на всех путях сборки результата, включая тот, где модель завершает работу напрямую, не обращаясь к инструментам. Это не перестраховка: ровно на этом пути расчёты одно время молча не считались — последний шаг проходил мимо единственного места, где движок вызывался.
- Сравнение с напечатанным значением ведётся с допуском на округление. Без допуска каждая вторая строка таблицы становилась бы «расхождением» из-за третьего знака после запятой, и полезный сигнал утонул бы в шуме.